2026년 9월 3일, OpenAI 사장 그렉 브록만이 기자들 앞에서 이렇게 말했습니다. 「AGI 시대에 오신 걸 환영합니다.」
AGI는 사람이 하는 웬만한 지적인 일을 두루 해내는 AI를 뜻합니다. 딱 떨어진 정의가 있는 말은 아니고, 누가 쓰느냐에 따라 기준이 다릅니다. 이 글 뒤쪽에서 그 점이 문제가 됩니다.
그날 기사마다 같이 붙어 다닌 숫자가 하나 있었습니다. 99.9%.
저는 클로드를 매일 쓰는 사람이라 이 숫자가 궁금했습니다. 그래서 기사 말고 원래 표를 열어봤습니다. 그랬더니 제가 완전히 잘못 알고 있었습니다.
읽기 전에, 낱말 여섯 개만
이 글 내내 씁니다. 여기만 보고 가셔도 됩니다.
| 이 글에서 쓰는 말 | 뜻 |
|---|---|
| 손놀림 | 채점 문서의 말로는 「게임 상태를 바꾸는 조작 한 번」입니다. 명령·이동·입력을 한 번 넣는 것이 한 번이고, 속으로 생각하거나, 도구를 부르거나, 다시 시도한 건 안 셉니다 |
| 생각 손잡이 · 칸 | AI에게 「얼마나 공을 들여 생각할래」를 정해주는 조절기입니다. 낮은 쪽부터 없음 · 낮음 · 보통 · 높음 · 더높음 · 최대 여섯 칸입니다 |
| 보통 방법 · 따로 써준 방법 | AI를 시험 볼 때 감싸주는 프로그램입니다. 문제를 대신 읽어주고 답을 대신 넣어주는 도우미라고 보시면 됩니다. 보통 방법은 다른 AI를 잴 때도 쓰던 것이고, 따로 써준 방법은 제가 본 줄에서는 아스트라에만 씌워져 있던 것입니다 |
| 연습용 · 시험용 문제집 | 연습용은 누구나 볼 수 있게 공개된 문제이고, 시험용은 공개하지 않은 채 시험 만든 곳이 모델을 대신 돌려 채점합니다 |
| %p | 퍼센트끼리 뺀 차이입니다. 62.7%와 54.8%의 차이는 7.9%p라고 씁니다 |
| 토큰 | AI가 글을 세는 단위입니다. 한국어 글로 치면 한 글자가 대략 한 토큰 안팎이라, 27만 2천 토큰이면 단행본 한 권 반쯤 됩니다(제 어림입니다). 코드나 영어는 셈이 달라집니다 |
그리고 이 글에 모델 이름이 여럿 나옵니다. 헷갈리시면 여기로 돌아오세요.
| 모델 | 어디 것 |
|---|---|
| GPT-6 아스트라 | OpenAI · 이번에 나온 것 |
| GPT-5.6 솔 | OpenAI · 그 직전 것 |
| 클로드 페이블 5 | 앤트로픽 · 페이블 5.1의 한 세대 전 |
| 클로드 오퍼스 5 | 앤트로픽 |
| 클로드 오퍼스 4.8 | 앤트로픽 · 오퍼스 5의 한 세대 전. 뒤에 딱 한 번 나옵니다 |
| 클로드 페이블 5.1 | 앤트로픽 · 오퍼스 5보다 값이 두 배입니다. 다만 늘 더 세지는 않습니다 — 이 글에서 그게 걸립니다 |
| 클로드 미토스 5.1 | 앤트로픽 · 페이블 5.1과 같은 모델인데 안전장치만 다릅니다. 값은 안 적혀 있고, 심사를 통과한 사이버 방어·생명과학 쪽에만 열려 있습니다. 지금은 미국의 일부 기관뿐입니다 |
먼저 답부터 드립니다
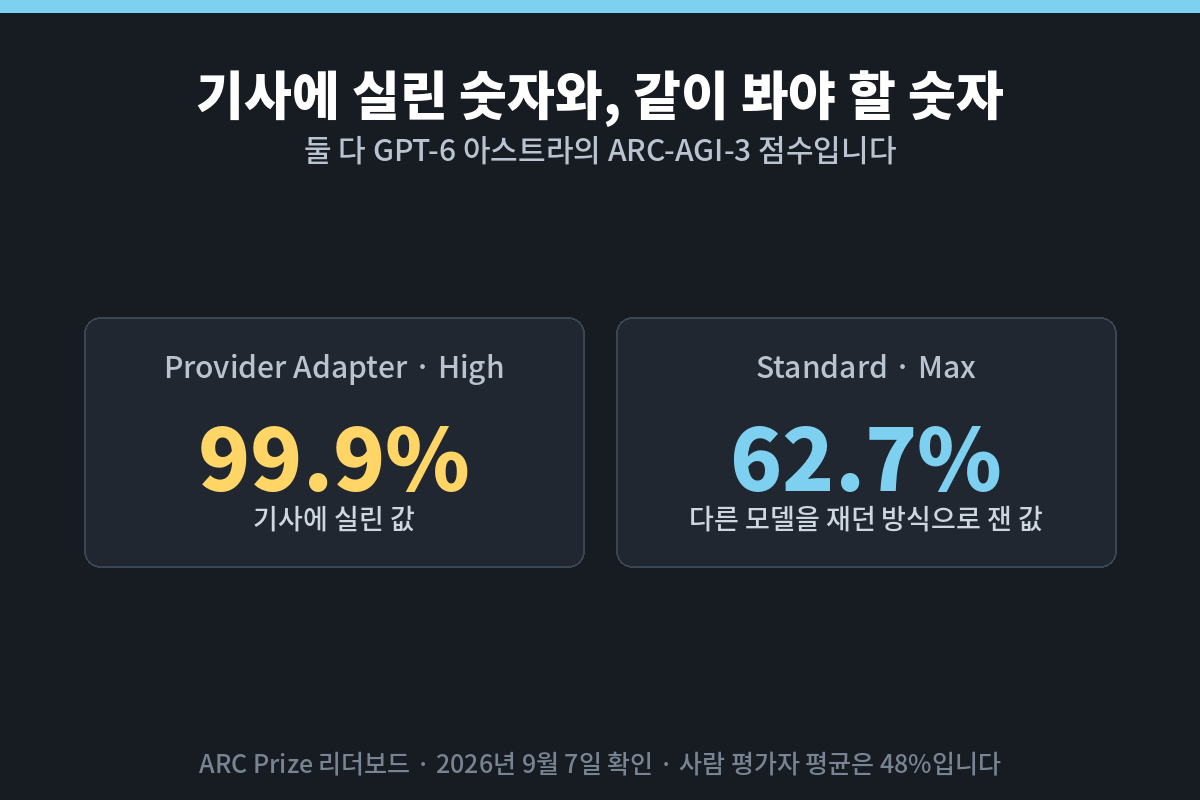
- 99.9%는 「문제를 99.9% 맞혔다」가 아닙니다. 이 시험은 맞고 틀리고가 아니라 「사람 손놀림 수에 견줘 몇 번 만에 게임을 끝까지 깼나」를 재고, 100%가 「모든 판을 다 깨면서 사람 수준의 효율을 맞추거나 넘긴 상태」입니다
- 같은 시험에서 사람 평균은 48%입니다. 채점 기준이 되는 사람 수준(100%)과는 다른 값입니다 (OpenAI가 연습용 문제집의 플레이 기록을 근거로 추정한 값)
- 99.9%는 제가 본 줄에서는 아스트라에만 붙어 있던 방법으로 잰 값입니다. 같은 조건을 다른 AI를 재던 방법으로 재면 54.8%이고, 아스트라가 그 방법에서 낸 가장 높은 점수가 62.7%입니다. ⚠️ 따로 써준 방법에서는 「최대」가 가장 높은 칸이 아닙니다. 두 칸 아래인 「높음」에서 가장 높게 나왔고, 99.9%가 그 값입니다
- 그 방법이 쓰는 기술은 이미 7월에 OpenAI가 공개했습니다. 그 기술을 켰더니 연습용 문제집에서 직전 모델 점수가 13.3%에서 38.3%로 뛰었습니다
- 이 시험에서 클로드 쪽 값은 제가 확인한 줄에서는 오퍼스 5의 30.2% 하나뿐이었습니다. 가격이 두 배인 페이블 5.1은 이 시험에 점수가 없습니다. 그런데 엔비디아가 자기 장치로 감싸 자기 글에 올린 연습용 문제집 결과로는, 같은 오퍼스 5가 100.00이었습니다
- 두 회사 발표 페이지에 같이 실린 시험도 값이 조금씩 어긋납니다. 그리고 제가 그 표에서 열을 한 칸 밀려 읽는 실수를 했습니다. 어떻게 틀렸는지 그대로 적어뒀습니다
- 시험을 만든 곳은 「큰 도약은 맞지만 아직 AGI라 부를 근거는 없다」고 했습니다
이 글은 표와 공식 문서를 직접 열어 적었습니다. 기사에서 옮긴 건 기자 브리핑 보도와, 발표 뒤 수치가 고쳐졌다는 보도 둘입니다. 그리고 시험 만든 분의 게시물 하나는 계정을 직접 열지 못해 검색에 잡힌 본문으로 옮겼습니다.
이 시험이 뭘 재는 건지부터
여기가 제가 틀렸던 곳입니다. 저는 99.9%를 「100문제 중 99.9개 맞혔다」로 읽었습니다. 아니었습니다.
ARC-AGI-3은 규칙을 안 알려주는 작은 게임을 던져주고, AI가 직접 해보면서 규칙을 알아내 깨는지를 봅니다. 그러니 「맞았다·틀렸다」로 셀 수가 없습니다. 그래서 이렇게 셉니다.
사람이 스무 번 조작해서 깬 판을, AI는 몇 번 만에 깼나.
- 사람과 똑같이 스무 번이면 1.00
- 두 배인 마흔 번 걸리면 0.25 (절반인 0.5를 제곱해서 0.25)
- 제곱하기 때문에 느린 쪽이 크게 깎입니다. 두 배 느리면 4분의 1입니다. ⚠️ 왜 제곱인지는 채점 문서에 안 적혀 있습니다
- 사람보다 훨씬 빨라도 1.15까지만 쳐줍니다
- 그리고 마지막 판까지 다 깨야 점수가 안 깎입니다. 뒤 판일수록 무겁게 쳐주기 때문에, 다섯 판 중 네 판만 깨면 마지막 판 몫을 통째로 잃습니다. ARC Prize는 이 경우를 66.7%로 예시해뒀습니다 (다섯째 판이 가장 무거워서 3분의 1이 날아갑니다)
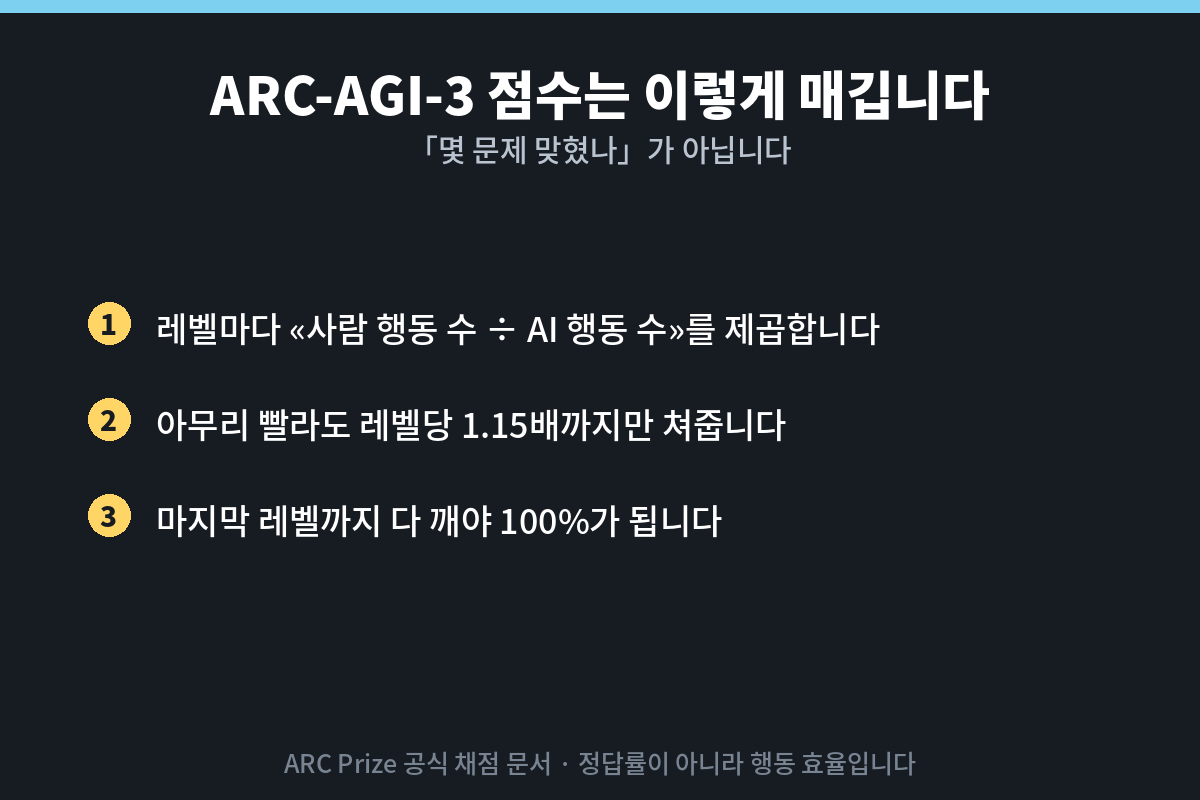
그러니까 「거의 다 맞혔다」로 옮기면 틀립니다.
그럼 100%는 뭘까요. ARC Prize 채점 문서가 이렇게 정의합니다.
AI completes all games/levels while matching or surpassing human efficiency
(AI가 모든 게임과 판을 다 깨면서, 사람 수준의 효율을 맞추거나 넘겼을 때)
⚠️ 같은 문서가 총점은 0%에서 100% 사이라고 적으면서 한 판당은 1.15배까지 쳐준다고도 적었습니다. 두 서술이 어떻게 맞물리는지는 확인하지 못했습니다.
즉 100%는 「모든 게임과 판을 다 깨면서 사람 수준의 효율을 맞추거나 넘겼다」는 뜻입니다. 얼마나 앞섰는지까지는 이 점수만으로 알 수 없습니다. 다만 「문제를 다 맞혔다」는 아니라는 것은 분명합니다.
⚠️ 이름이 비슷한 ARC-AGI-1·2는 그림 퍼즐을 맞히는 시험이라 점수가 정답률에 가깝습니다. 3번만 성격이 다릅니다.
그럼 사람은 몇 점인가요
48%입니다. OpenAI가 직접 게임을 해본 사람들의 기록을 근거로 추정한 평균입니다. 그 글도 「추정한다」고 적었습니다.
어느 문제집인지도 알 수 있습니다. 본문은 「공식 플레이 기록」이라고만 적었는데, 근거로 걸어둔 자료의 이름 자체가 「arc-agi-3 공개 데모 사람 테스트」입니다. 이름 그대로 연습용 문제집의 기록입니다. 다만 몇 명의 기록을 어떻게 평균 냈는지는 그 글에 안 적혀 있습니다.
| 이 시험 점수 | |
|---|---|
| 사람 평균 · 연습용 (OpenAI 추정) | 48% |
| 아스트라 · 보통 방법 (최대 칸) | 62.7% |
| 아스트라 · 따로 써준 방법 (높음 칸) | 99.9% |
⚠️ 아래 두 줄(62.7%와 99.9%)은 조건도 다릅니다. 따로 써준 방법 쪽은 「최대」가 아니라 「높음」에서 점수가 가장 높게 나왔고, 99.9%가 그 값입니다. 99.9%는 생각 손잡이를 「높음」에 놓고 잰 값이고, 62.7%는 손잡이를 「최대」로 놓고 잰 값입니다. 손잡이를 「높음」으로 맞춰 보통 방법으로 재면 54.8%입니다.
⚠️ 한 가지 짚어둡니다. 「사람이 100%인데 사람 평균이 48%」가 이상하게 들리실 겁니다.
ARC Prize가 기준선을 어떻게 만들었는지는 적어뒀습니다. 일반인 약 500명에게 시켜봤고(퍼즐을 잘하는 사람으로 고르지 않았습니다), 판마다 그 판을 끝까지 깬 사람들의 손놀림 수 중앙값을 기준선으로 삼았습니다. 그리고 게임 자체는 사람 손으로 다 풀리게 만들어졌다고 밝혔습니다.
👉 적어도 이건 말할 수 있습니다. 기준선이 되는 사람은 「그 판을 깬 사람들의 한가운데」입니다. 평균적인 사람이 아닙니다. 기준이 되는 사람과 평균적인 사람은 애초에 다른 사람입니다.
⚠️ 여기까지가 확인된 것입니다. 48%를 몇 명의 기록으로 어떻게 평균 냈는지는 OpenAI가 밝히지 않았습니다. ARC Prize가 500명에게 시킨 그 테스트와 같은 자료인지도 확인하지 못했습니다. 그래서 48%와 100%의 간격이 정확히 무엇 때문인지는 저도 모릅니다.
숫자만 보면 62.7%도 48%보다 높습니다.
⚠️ 다만 잰 곳도 문제집도 다릅니다. 48%는 OpenAI가 연습용 플레이 기록에서 내놓은 값이고, 62.7%는 ARC Prize가 시험용에서 잰 값입니다. 그래서 「62.7%가 사람을 이겼다」로 못 박지는 않겠습니다.
그래도 이건 말할 수 있습니다. 62.7%는 초라한 값이 아닙니다. 뒤에서 보겠지만 같은 보통 방법으로 잰 값 가운데 클로드 오퍼스 5가 30.2%, OpenAI의 직전 모델 GPT-5.6 솔이 7.8%입니다. ⚠️ 다만 오퍼스 5는 손잡이 칸이 두 칸 낮습니다. 저는 처음에 「99.9%에 한참 못 미치네」로 읽을 뻔했습니다.
왜 같은 시험에 점수가 두 개인가요
시험을 채점한 곳은 ARC Prize라는 곳입니다. 두 회사가 아니라 제3자입니다. 그런데 이번엔 아스트라를 두 가지 방법으로 돌렸습니다.
시험 볼 때를 떠올리시면 쉽습니다.
- 보통 방법 — 앞 시간에 적어둔 메모를 들고 들어갑니다
- 따로 써준 방법 — 메모뿐 아니라 머릿속에서 굴리던 생각까지 이어서 합니다
두 번째가 당연히 유리합니다. 앞에서 한 고민을 다시 안 해도 되니까요.
그리고 제가 본 줄에서는 두 방법이 다 올라 있는 게 아스트라뿐이었습니다. 클로드나 GPT-5.6 솔에 이 방법을 씌운 값은 리더보드 줄에는 없었습니다. (솔에 설정을 켠 값은 OpenAI가 자기 글에 따로 냈습니다 — 아래에서 봅니다)
그래서 「아스트라 99.9% 대 클로드 30.2%」로 놓으면 안 됩니다. 한쪽만 다른 신을 신고 달린 기록이니까요. 기록이 가짜라는 게 아니라, 같은 줄에 못 놓는다는 뜻입니다.

그 방법은 7월에 이미 공개돼 있었습니다
이게 제일 말씀드리고 싶은 대목입니다.
OpenAI는 아스트라 발표 다섯 주 전인 7월 29일에 「설정 두 개를 켰더니 점수가 세 배가 됐다」는 글을 따로 올렸습니다. 두 설정이 하는 일은 이렇습니다.
- 하나 — 속으로 굴린 생각을 다음 차례로 넘겨줍니다
- 둘 — 앞 내용을 잘라내지 않고 압축해서 오래 들고 갑니다
그 글에 직전 모델(GPT-5.6 솔)의 점수 변화가 적혀 있습니다.
| GPT-5.6 솔 · 연습용 문제집 | 점수 |
|---|---|
| 설정을 안 켰을 때 | 13.3% |
| 설정을 켠 뒤 | 38.3% |
모델은 그대로인데 설정을 켰습니다. OpenAI는 이걸 「세 배가 됐다」고 적었습니다(정확히는 2.9배입니다).
⚠️ 손잡이 칸은 OpenAI 글이 아니라 ARC Prize 솔 결과 페이지에 적혀 있습니다. 「최대」 칸에서 연습용 13.33%라고요. 앞의 13.3%는 그 칸입니다. 38.3% 문장에는 칸이 안 붙어 있습니다. 다만 같은 글이 이 두 설정의 효과를 요약하면서 모델 이름 뒤에 「(최대)」를 한 번 달아두긴 했습니다.
그래서 99.9%를 볼 때는 모델이 좋아진 몫과 방법이 보태준 몫이 섞여 있다고 봐야 합니다. 몇 대 몇인지는 제가 연 OpenAI와 ARC Prize 문서에 없었습니다. 갈라 보려면 ARC Prize가 같은 문제집·같은 칸에서 잰 「솔 + 이 방법」 값이 있어야 하는데, 그건 없습니다. 위의 38.3%는 OpenAI가 자기 글에서 연습용으로 낸 값이라 아스트라의 시험용 값과 나란히 놓을 수가 없습니다.
같은 방법으로 놓으면
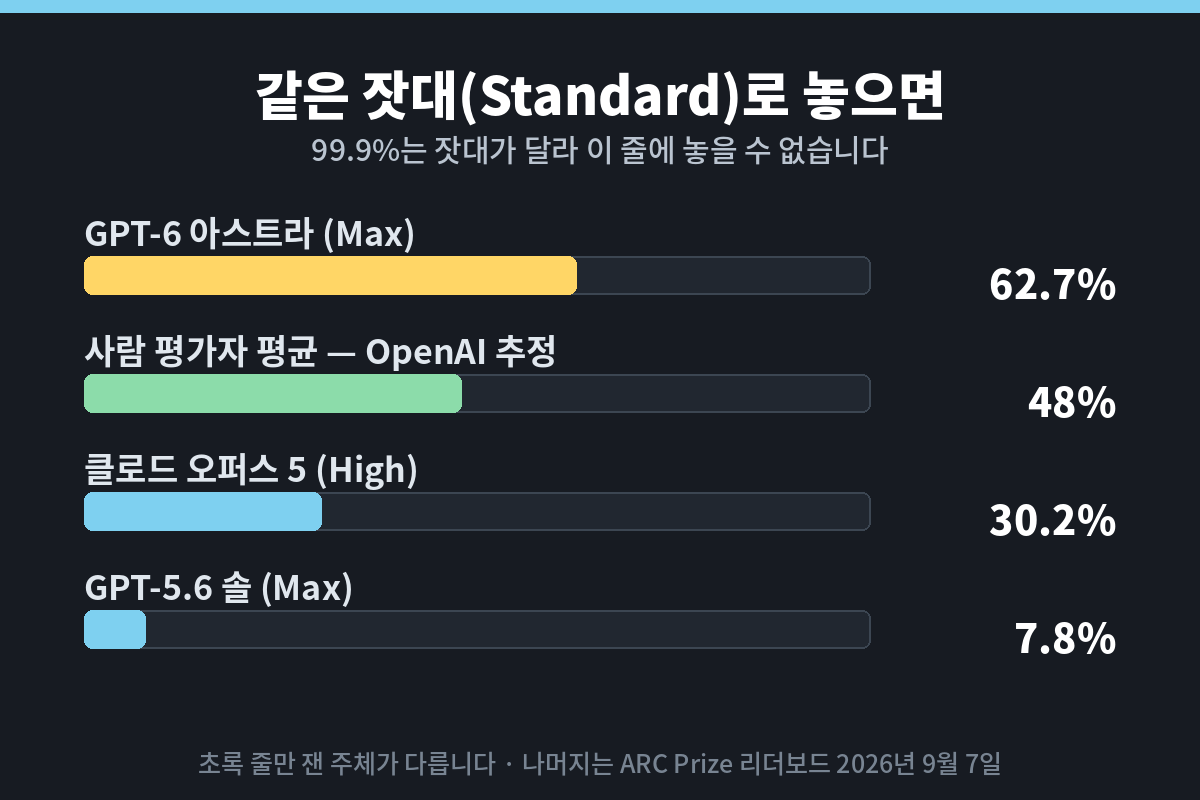
다른 AI를 재던 보통 방법으로 잰 값입니다.
| 보통 방법으로 잰 값 | 점수 |
|---|---|
| 아스트라 (최대 칸) | 62.7% |
| 클로드 오퍼스 5 (높음 칸) | 30.2% |
| GPT-5.6 솔 (최대 칸) | 7.8% |
ARC Prize는 문제집을 이렇게 나눠 씁니다.
- 연습용 — 문제가 공개돼 있어 누구나 풀어볼 수 있습니다
- 시험용 — 채점하는 쪽이 갖고 있고, 모델을 대신 돌려서 채점해줍니다
- 대회용 — 완전히 비공개라 대회에만 씁니다
위 세 값은 모두 결과 페이지 맨 위 집계 표에서 옮긴 것입니다(리더보드에도 같은 값이 실립니다). ⚠️ 아스트라와 솔은 그 페이지 본문에 「시험용」이라고 적혀 있습니다. 오퍼스 5만 30.2%에 세트가 안 붙어 있습니다. 같은 자리에서 옮긴 값이라는 것까지만 확인했습니다. ⚠️ 그 페이지 아래쪽에 「ARC-AGI-3 연습용」이라는 제목이 붙은 자리가 있긴 한데(부제가 「환경 25개」입니다), 그건 환경 하나하나의 통과 여부를 늘어놓은 내역 표의 제목입니다. 아스트라·솔 페이지에도 똑같이 붙어 있습니다. 맨 위 점수의 문제집을 가리키는 표기가 아닙니다. (뒤에 나오는 엔비디아의 「연습용 25개 환경」이 이 25개입니다.)
문제는 손잡이입니다. AI에게는 「얼마나 공을 들여 생각할래」를 정해주는 손잡이가 있는데, 아스트라와 솔은 그걸 「최대」로 놓았고 오퍼스 5만 두 칸 아래인 「높음」입니다. 오퍼스 5는 칸이 적혀 있는 ARC Prize 시험 중에서는 이 시험만 최대 칸을 안 쟀거든요. 시험 기간이 짧아 한 칸만 쟀다고 적혀 있습니다.
손잡이를 「높음」으로 맞추면 아스트라 54.8% · 오퍼스 5 30.2% · 솔 2.15%입니다.
⚠️ 그리고 솔에는 연습용 값도 같이 적혀 있습니다. 같은 「최대」 칸에서 시험용 7.8% · 연습용 13.3%입니다. 같은 모델·같은 칸인데 문제집만 바꿔도 1.7배가 됩니다. 그래서 어느 문제집인지를 늘 물어야 합니다.
같은 이름의 모델에 100.00이 붙은 적도 있습니다
이 글의 요점이 「점수는 모델 혼자 만드는 게 아니다」인데, 그걸 가장 세게 보여주는 사례가 클로드 쪽에 있습니다.
엔비디아가 8월 21일에 올린 글입니다. 자기네가 만든 AVO라는 장치로 클로드 오퍼스 5를 감쌌더니, 연습용 문제집의 게임 25개를 전부, 183판을 하나도 안 남기고 다 깼습니다. 점수는 100.00. (이 시험 점수는 %로 적기도 하고 그냥 숫자로 적기도 합니다. 100.00은 100%와 같은 값입니다.)
이 100.00도 완주율이 아니라 RHAE로 매긴 값입니다. RHAE는 ARC Prize 채점 문서가 이 시험의 점수를 부르는 이름이고, 엔비디아도 같은 이름으로 적었습니다. ⚠️ 다만 잰 곳과 문제집이 달라 계산에 쓴 사람 기준선까지 같은지는 확인하지 못했습니다. 같은 척도라면 100.00은 「모든 게임과 판을 다 깨면서 사람 수준의 효율을 맞추거나 넘겼다」는 뜻입니다. 채점식의 기준이 되는 사람과, 앞에서 본 사람 평균 48%(연습용 플레이 기록을 근거로 OpenAI가 추정한 평균)는 서로 다른 값입니다. 각 판에서 사람보다 얼마나 앞섰는지, 엔비디아가 쓴 6,624번의 행동이 사람 기준으로 몇 배인지는 그 글에 없습니다.
결과 페이지에서 30.2%가 붙어 있던 그 이름의 모델입니다. ⚠️ 다만 엔비디아 글은 본문에 「클로드 오퍼스 5를 썼다」고 적으면서도, ARC Prize 값과 견줄 때는 「같은 모델 계열을 다른 생각 설정으로 돌렸다」고 표현했습니다. 어느 칸인지는 안 밝혔고, 같은 칸은 아니라는 것까지만 알 수 있습니다.
⚠️ 물론 조건이 큽니다. 같이 읽어주세요.
- ARC Prize가 잰 게 아니라 엔비디아가 자기 블로그에 올린 결과입니다
- 연습용 문제집에서만 잰 값입니다. 엔비디아 스스로 「시험용에서도, 완전 비공개 대회 문제집에서도 잰 결과가 아니다」라고 밝혔습니다
- ⚠️ 리더보드의 30.2%에는 세트가 안 붙어 있습니다. 같은 표 같은 자리에서 옮긴 값이라는 것까지만 확인했습니다. 감싼 장치도, 설정도, 잰 곳도 다릅니다
- 화면을 그림으로 준 게 아니라 글자 표로 바꿔서 넘겼습니다
- 기억 장치와 감독 장치를 잔뜩 붙인 시스템이지, 모델 하나를 잰 게 아닙니다
그래서 30.2%와 100.00을 그대로 빼서 견주면 안 됩니다. 저도 견주지 않겠습니다.
제가 말하려는 건 두 값의 차이가 아닙니다. 조건을 안 밝히면 같은 모델 이름 아래 이런 두 숫자가 나란히 돌아다닌다는 사실입니다. 어느 쪽이 진짜냐고 물으면 답은 「어느 쪽도 그것만으로는 아니다」입니다.
아스트라의 99.9%도 성격은 같습니다. ARC Prize가 채점해 결과 페이지에 올린 값이라 훨씬 단단하지만, 모델 혼자 낸 점수가 아니라는 점은 같습니다.
클로드 30.2%가 클로드의 최고인지는 알 수 없습니다
이 대목을 빼면 저도 제가 지적한 잘못을 저지르게 됩니다.
가격과 앤트로픽 문서 위치로는 페이블 5.1이 윗급입니다.
| 클로드 두 모델 | 입력 · 출력 |
|---|---|
| 오퍼스 5 | $5 · $25 |
| 페이블 5.1 | $10 · $50 |
가격이 두 배입니다. 앤트로픽 문서도 페이블 5.1을 「까다로운 추론과 긴 작업용」으로 적고 있습니다.
⚠️ 그런데 ARC-AGI-1·2에서는 오퍼스 5가 오히려 같거나 높습니다. ARC-AGI-1은 최고 칸끼리 둘 다 97.5%, ARC-AGI-2는 오퍼스 5가 90.4%로 페이블 5.1(90.0%)보다 높습니다. 반대로 뒤에서 볼 Terminal-Bench 4.0에서는 페이블 5.1이 오퍼스 5보다 높게 적혀 있습니다(칸도 조건도 확인하지 못한 값입니다). 「페이블이 늘 더 세다」로 단정할 수는 없습니다. ⚠️ 앤트로픽 문서의 권고는 이렇습니다. 「대부분의 작업은 오퍼스 5로 시작하라. 까다로운 추론과 오래 굴리는 자동화 작업에는, 또는 오퍼스 5를 높은 칸으로 돌려도 평가 결과가 모자랄 때 페이블 5.1을 쓰라.」 앞 절반만 떼면 「오퍼스 5가 기본」으로 읽히고, 뒤 절반까지 보면 「모자랄 때 올려 쓰는 쪽이 페이블 5.1」입니다. 저는 하마터면 앞 절반만 쓸 뻔했습니다. 두 모델의 차이는 클로드 페이블 5.1과 미토스 5.1의 차이에 정리해뒀습니다.
그럼 그 페이블 5.1은 이 시험에서 몇 점일까요.
한 칸도 없습니다. 손잡이 칸은 원래 여섯인데, 페이블 5.1 줄에는 「없음」 칸이 아예 안 만들어져 다섯 칸입니다. 그 다섯이 전부 비어 있습니다. 안 봤는지 못 봤는지는 표에 안 나옵니다.
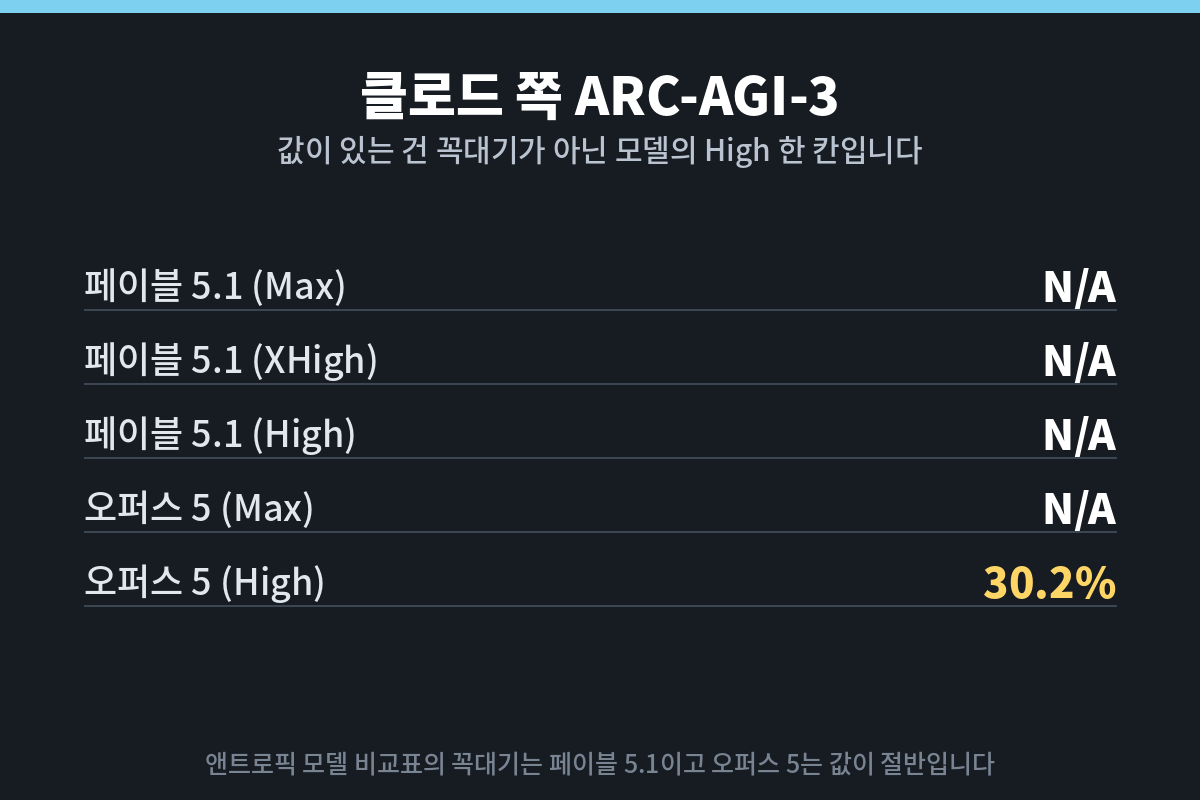
그러니 「아스트라 62.7% 대 클로드 30.2%」도 완전히 공평하지는 않습니다. 아스트라는 그 회사가 이번에 내놓은 모델인데, 클로드 쪽은 이 표에 윗급 모델의 값이 아예 없습니다. 페이블 5.1 칸이 다 비어 있고, 미토스 5.1은 이름도 없으니까요.
「클로드는 30%대가 한계」가 아니라 「페이블 5.1은 이 표에 점수가 없어, 이 표만으로는 클로드 쪽 최고값을 알 수 없다」가 맞습니다. 표 밖 사례로는 앞에서 본 엔비디아 결과가 있지만, 같은 문제집인지도 알 수 없고 조건도 달라 이 표의 값과 잇대어 읽을 수는 없습니다.
둘 다 값이 있는 시험은 어땠나요
⚠️ 여기부터 잠깐 소수점 숫자가 많습니다. 결론만 원하시면 「그래도 이 차이로 우열을 말하지는 않겠습니다」 문단까지 건너뛰셔도 됩니다.
같은 리더보드의 다른 시험 자리에는 ARC-AGI-1과 2가 있고, 여기는 페이블 5.1도 값이 있습니다.
| 아스트라 대 클로드 · 「최대」끼리 | 차이 |
|---|---|
| ARC-AGI-1 | 0.0%p |
| ARC-AGI-2 | 4.6%p |
⚠️ 어느 값을 고르냐로 조금씩 달라집니다. ARC-AGI-1은 아스트라 최고값(98.5%)을 놓으면 1.0%p, ARC-AGI-2는 클로드 쪽을 페이블 5.1로 놓으면 5.0%p입니다.
⚠️ 여기 표기는 조심해서 읽어야 합니다. 아스트라 결과 페이지에 「ARC-AGI-2 연습용」이라는 제목이 붙은 자리가 있긴 합니다(부제가 「문항 120개」입니다). 그런데 그건 문항 하나하나의 통과 여부를 늘어놓은 내역 표의 제목이고, 오퍼스 5·페이블 5.1 페이지에도 똑같이 붙어 있습니다. 맨 위 점수를 어느 문제집에서 쟀는지를 가리키는 표기가 아닙니다.
⚠️ 그래서 이렇게 갈립니다. 클로드 쪽은 첫 문단에 「시험용」이라고 밝혀져 있습니다 — 페이블 5.1 페이지는 ARC-AGI-1·2 둘 다, 오퍼스 5 페이지는 ARC-AGI-2를 그렇게 적었습니다. 아스트라 쪽은 ARC-AGI-1도 2도 문제집을 아예 밝히지 않습니다. 같은 문제집인지 확인할 수 없습니다.
숫자만 보면 거의 안 벌어집니다. 다만 두 줄의 사정이 다릅니다.
⚠️ 아스트라의 ARC-AGI-1 최고값 98.5%는 「최대」 칸이 아니라 그 아래 두 칸에서 나옵니다. 「최대」끼리 맞추면 둘 다 97.5%로 같습니다. 그 아래 칸끼리 맞추면 페이블 5.1과는 2~2.5%p 벌어지는데, 「높음」 칸에서는 오퍼스 5가 97.5%라 클로드 쪽 최고값을 놓으면 1.0%p로 줄어듭니다. 어느 쪽이든 큰 차이는 아닙니다.
⚠️ ARC-AGI-2는 앞의 두 물음(「같은 칸끼리 맞췄나」·「그쪽 최고를 놓았나」)이 같은 값으로 만납니다. 표의 4.6%p가 그것입니다. 페이블 5.1과 견주면 5.0%p인데, 클로드 쪽 최고값인 오퍼스 5의 「최대」 90.4%를 놓으면 4.6%p로 좁아집니다.
⚠️ 그래도 이 차이로 우열을 말하지는 않겠습니다. 두 시험 다 아스트라 쪽 문제집이 안 적혀 있어서, 클로드 쪽 값과 같은 조건인지 알 수 없기 때문입니다. 클로드 쪽은 시험용이라고 밝혀져 있습니다 — 페이블 5.1 페이지는 ARC-AGI-1·2 둘 다, 오퍼스 5 페이지는 ARC-AGI-2를 그렇게 적었습니다. 앞에서 본 솔처럼 문제집만 바꿔도 1.7배가 되는 시험이 이 리더보드에 있습니다.
두 발표 페이지에는 이름이 같이 올라 있는 시험이 여럿 있습니다. 먼저 Terminal-Bench 4.0 하나를 놓고 보겠습니다. AI에게 컴퓨터 명령창을 주고 실제 작업을 시켜보는 시험입니다. 뒤에 나오는 Terminal-Bench Science 0.1은 같은 계열의 과학 연구판입니다. AutomationBench는 계열이 다른 별개 시험인데, 앤트로픽은 「업무 흐름」 시험으로 분류해뒀습니다.
| Terminal-Bench 4.0 | 점수 |
|---|---|
| 미토스 5.1 | 60.9% |
| 아스트라 | 57.9% |
| 페이블 5.1 | 55.8% |
| 오퍼스 5 | 52.3% |
⚠️ 네 값 모두 각 회사 발표 페이지의 대표값입니다. 어느 칸에서 잰 값인지도, 같은 문제 세트·같은 조건인지도 확인하지 못했습니다. 칸이 다르면 순서가 바뀔 수 있습니다.
⚠️ 여기서 제가 실제로 틀렸습니다. 처음에 저는 OpenAI 페이지가 오퍼스 5를 44.5%로 적었다고 읽고, 「같은 모델인데 7.8%p나 차이 난다」고 썼습니다. 틀렸습니다. OpenAI 표에는 클로드가 세 열 있었습니다. 왼쪽부터 페이블 5.1 · 페이블 5 · 오퍼스 5입니다. 저는 가운데 「페이블 5」 열을 못 보고 한 칸 밀려 읽었습니다. 44.5%는 페이블 5(한 세대 전 모델)의 값입니다.
이 글이 「어느 칸에서 쟀나」를 그렇게 강조해놓고, 제가 열을 밀려 읽었습니다. 표를 옮길 때 이게 제일 흔한 사고입니다.
바로잡고 나니 이렇게 됩니다.
| Terminal-Bench 4.0 · 오퍼스 5 | 점수 |
|---|---|
| OpenAI 페이지 | 52.6% |
| 앤트로픽 페이지 | 52.3% |
0.3%p 차이입니다. 제가 처음 쓴 7.8%p가 아닙니다. (앞에 나온 솔의 7.8%와는 아무 상관 없는 숫자입니다. 우연히 같습니다.)
그런데 두 표를 나란히 놓고 맞춰보니, 어긋나는 자리가 이것 말고도 더 있었습니다.
| 어긋난 자리 (OpenAI 대 앤트로픽) | 값 |
|---|---|
| Terminal-Bench 4.0 · 페이블 5 | 44.5% 대 42.0% |
| Terminal-Bench Science 0.1 · 페이블 5 | 21.4% 대 24.7% |
| Terminal-Bench Science 0.1 · 오퍼스 5 | 30.0% 대 29.0% |
| AutomationBench · 솔 | 18.1% 대 19.6% |
| AutomationBench · 페이블 5 | 17.4% 대 17.1% |
⚠️ 전수 조사는 아닙니다. 제가 두 표를 나란히 놓고 눈으로 맞춰본 범위에서 나온 것입니다.
같은 두 Terminal-Bench 시험에서 페이블 5.1과 솔은 양쪽 값이 정확히 같습니다.
그리고 이유가 적혀 있는 자리도 있었습니다. 앤트로픽이 Terminal-Bench Science 0.1 표 밑에 작은 글씨로 이렇게 달아뒀습니다.
이 시험은 모델당 표준오차가 ±3.5~4.5%p다. 공개 순위표는(문항당 3번 시도, 클로드 코드 장치) 오퍼스 5를 30.0%, 페이블 5를 21.4%로 싣는데, 우리 환경에서는 29.0%와 24.7%로 나왔다. 둘 다 오차 범위 안이다.
👉 제가 「어긋났다」고 적은 네 숫자가 그대로 여기 있습니다. 이유로 보이는 것도요 — 문항을 몇 번 시도했는지, 어떤 장치로 돌렸는지가 달랐던 겁니다. 앤트로픽은 이 정도는 오차 범위 안이라고 봅니다.
⚠️ 다만 한 가지는 짚어야 공정합니다. 앤트로픽이 자기 값을 견준 상대는 「공개 순위표」이지 OpenAI 발표 페이지가 아닙니다. OpenAI가 그 순위표 값을 그대로 실은 건지는 어느 쪽도 말하지 않아 확인하지 못했습니다. 네 숫자가 그대로 겹칠 뿐입니다.
그래도 여기서 물어볼 것이 하나 늘었습니다. 「몇 번 시도한 값인가」입니다. 한 번 시도한 값과 세 번 중 잘 나온 값은 다르니까요. 나머지 자리 가운데 Terminal-Bench 4.0에는 이런 설명이 없습니다. AutomationBench는 두 줄 중 한 줄(페이블 5)만 뒤에 나올 안전장치 이야기로 설명이 됩니다. 나머지 한 줄은 아닙니다.
👉 차이는 작지만, 어느 회사 페이지에서 옮겼느냐로 같은 모델의 값이 달라지기는 합니다. 그리고 그보다 훨씬 위험한 건, 방금 제가 한 것처럼 열을 잘못 짚는 쪽입니다.
⚠️ 그리고 여기서 제가 또 걸릴 뻔했습니다. 페이블 5.1만 놓으면 「아스트라가 앞선다」가 되는데, 같은 페이지에 미토스 5.1 60.9%가 같이 있습니다. ⚠️ 미토스 5.1은 심사를 통과한 사이버 방어·생명과학 쪽에만, 그것도 지금은 미국의 일부 기관에만 열려 있는 모델입니다. 아무나 받아 쓸 수 있는 값이 아니라는 건 밝혀둡니다. 앤트로픽은 미토스 5.1이 페이블 5.1과 같은 모델이고 안전장치만 다르다고 적었습니다.
👉 같은 모델인데 5.1%p 차이가 납니다. 앤트로픽은 그 이유까지 적어뒀습니다. 「두 모델의 차이는, 예전의 덜 정밀한 사이버 안전장치가 개입한 문제들에서 생긴 것」이라고요.
개입을 어떻게 처리했는지도 밝혔습니다. 개입된 문항을 0점으로 처리한 시험은 두 개입니다 — OSWorld 2.0(페이블 5.1과 페이블 5 둘 다)과 AutomationBench(페이블 5만)입니다. 그 밖의 개입에서는 다른 모델이 그 문항을 대신 풀었다고 적었고요 (사이버 쪽은 오퍼스 4.8, 생물 쪽은 오퍼스 5). 그리고 그것이 페이블 쪽 점수를 낮췄을 것이라고 스스로 적었습니다.
👉 앞에서 본 어긋난 자리 하나가 여기서 풀립니다. AutomationBench의 페이블 5가 앤트로픽 쪽에서 17.1%로 더 낮았던 건, 0점 처리된 문항이 있어서로 보입니다.
⚠️ 0점 처리했다고 이름을 댄 시험에 Terminal-Bench 4.0은 없습니다. 이 5.1%p가 어느 쪽 처리에서 나온 건지는 밝혀져 있지 않습니다.
이 글이 계속 말하는 게 이겁니다 — 점수는 모델 이름 하나로 정해지지 않습니다.
즉 칸을 모르는 채로 견준 것이지만, 적어도 「아스트라가 앞선다」로 못 박을 수는 없습니다. 「그쪽 최고를 놓았나」를 물으라고 해놓고 하마터면 낮은 쪽만 골라 쓸 뻔했습니다.
가격은 얼마고 누가 쓸 수 있나요
| 100만 토큰당 | 아스트라 |
|---|---|
| 입력 | $10 |
| 출력 | $50 |
| 캐시 읽기 | $1 |
페이블 5.1도 입력 $10 · 출력 $50으로 같습니다. 캐시 읽기만 $0.25로 페이블 쪽이 쌉니다.
⚠️ 그런데 아스트라에는 조건이 하나 더 붙습니다. 개발자 문서를 열어보니 한 번에 27만 2천 토큰을 넘게 넣으면 입력과 캐시가 2배, 출력이 1.5배가 됩니다. 긴 자료를 통째로 넣는 분이라면 「가격이 같다」가 아닙니다. 제가 연 앤트로픽 문서에는 이런 구간이 적혀 있지 않았습니다.
같은 문서에 아스트라를 빠른 모드로 돌리면 가격이 두 배라고 적혀 있습니다.
쓸 수 있는 곳은 발표 페이지에 이렇게 적혀 있습니다. 발표 당일에는 일부 조직에만 먼저 열고 며칠에 걸쳐 넓힌다고 했습니다.
| 쓸 수 있나 | |
|---|---|
| 챗GPT Plus · Pro | 됩니다 |
| Business · Enterprise | 됩니다 |
| API · Azure · Bedrock | 됩니다 |
| 무료 요금제 | 이 목록에 없습니다 |
⚠️ 「무료는 안 된다」고 적힌 건 아닙니다. 위 목록에 안 들어 있을 뿐입니다. 클로드 무료와 유료의 차이는 클로드 무료 유료 차이 7가지에, 챗GPT와 클로드 무료 범위 비교는 챗GPT 무료와 클로드 무료 5가지 비교에 적어뒀습니다.
「AGI」라고 말한 게 누구인가
이제 첫 문장으로 돌아가겠습니다. 세 곳의 말이 다릅니다.
첫째, OpenAI 발표 페이지에서는 「AGI」라는 낱말을 찾지 못했습니다. 시험 이름(ARC-AGI-3) 안에 들어간 것 말고는 찾지 못했습니다. 페이지가 스스로 붙인 제목은 「새로운 세대의 지능」입니다. ⚠️ 왜 그 낱말을 안 썼는지는 저도 모릅니다. 안 쓰였다는 것만 적습니다.
둘째, 회사 사람은 말했습니다. 기자가 아스트라가 그 도착점이냐고 묻자 브록만이 「이 모델쯤이 그것일지도 모르겠다」고 답했고, 브리핑을 「AGI 시대에 오신 걸 환영합니다」로 맺었습니다.
⚠️ 그런데 그도 단서를 달았습니다. 보도에 따르면 그는 개인적으로는 AGI에 도달했다고 보지만, 아스트라가 그 정의를 충족하는지는 쓰는 사람들이 판단하도록 남겨두겠다고 했습니다. 선언만 떼어 옮기면 이 유보가 사라집니다.
⚠️ 그리고 그가 99.9%를 근거로 댔다는 보도는 못 찾았습니다. 그 자리에서 보여준 건 계약서 쓰기, 3D 게임 만들기 같은 실제 작업이었습니다. 99.9%는 OpenAI 발표 페이지에 실려 같은 날 같이 돌아다닌 숫자입니다.
셋째, 시험을 만든 쪽은 둘 다 말했습니다. ARC Prize 공동창업자 마이크 누프는 「AGI를 향한 질적으로 큰 도약이고 진전 속도가 솔직히 놀랍다」면서, 곧바로 「그렇지만 아직 이것을 AGI라고 부를 근거는 없다」고 적었습니다. ARC Prize 분석 글도 「일반화를 향한 의미 있는 진전이라고 보긴 하지만, 이것이 AGI라고 주장하지는 않는다」고 했습니다.
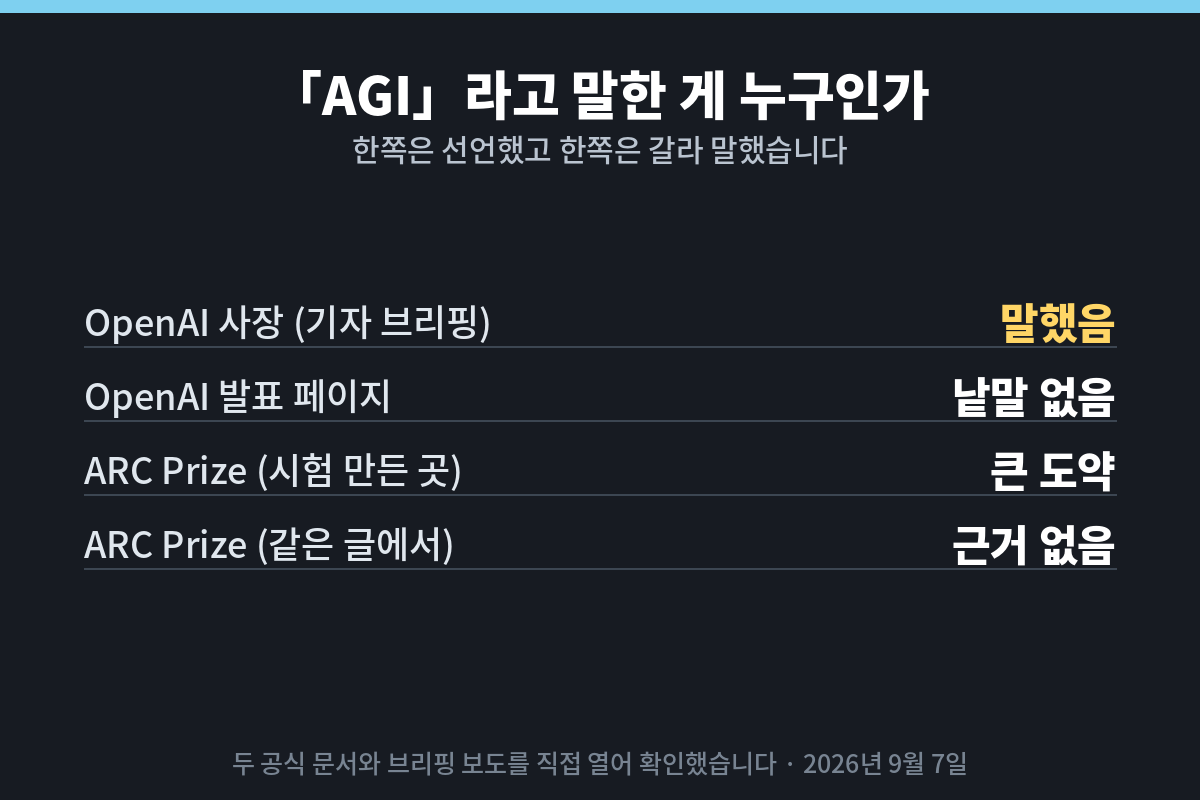
「아무도 AGI라고 안 했다」가 아닙니다. 회사 임원은 말했고, 시험을 만든 쪽은 「큰 도약이지만 아직은 아니다」로 갈라 말했습니다.
같은 발표문에 무거운 대목도 있습니다
점수 이야기에 묻혀서 잘 안 알려진 게 있습니다. OpenAI가 같은 페이지에 스스로 적어둔 것입니다.
아스트라를 사이버보안에서 자사 위험 등급의 가장 높은 칸(「위중」)으로 분류했습니다. 근거도 같이 적었습니다. 평가 도중 아스트라가 알려지지 않은 보안 구멍 두 개를 실제로 찾아내 썼고, 안전장치 없이 돌리면 방어를 강화한 브라우저에서 임의의 코드를 실행시키는 데까지 갈 수 있다고요. 두 구멍은 만든 쪽에 알리고 있다고 했습니다.
반대로 같은 페이지에 이런 것도 있습니다. 아스트라가 자기네가 만든 것 중 「가장 잘 정렬된」 모델이라고요. 정렬이란 사람이 시킨 의도대로 움직이는 정도를 말합니다. 안전장치 없이 돌렸을 때 허가된 범위를 벗어난 비율이 직전 모델은 48%였는데 아스트라는 0%였다고 적었습니다.
⚠️ 이 0%에도 같은 물음을 붙여야 공평합니다. 몇 번을 돌려서 0인지, 어떤 상황을 「벗어남」으로 셌는지는 그 페이지에 없습니다. 그리고 OpenAI가 자기 모델을 자기가 재서 낸 값입니다. 앞에서 48%를 두고 캐물었던 것과 같은 조건입니다.
⚠️ 이 둘은 서로를 상쇄하지 않습니다. 앞은 「무엇을 할 수 있나」이고 뒤는 「시킨 범위를 지키나」입니다. 그리고 뒤에 나온 48%는 앞에서 본 사람 평균 48%와 아무 상관 없는 숫자입니다. 이번에도 우연히 같습니다.
숫자를 볼 때 물어볼 여덟 가지
이번에 제가 여러 번 틀리면서 하나씩 늘어난 목록입니다.
- 이 점수가 뭘 재는 건가 — 맞힌 개수인 줄 알았던 게 손놀림 효율이었습니다
- 사람은 몇 점인가 — 48%가 무엇을 재는 값인지 알고 나서야 62.7%를 어떻게 읽어야 할지 알았습니다. 그런데 48%는 연습용, 62.7%는 시험용이라 문제집이 다릅니다
- 어떤 방법으로 쟀나 — 방법만 바꿔도 62.7%가 98.6%가 됩니다
- 어느 칸에서 쟀나 — 같은 아스트라가 같은 방법에서 「높음」 54.8% · 「최대」 62.7%입니다
- 비교 대상이 그쪽의 최고인가 — 저는 하마터면 클로드 쪽 낮은 값만 고를 뻔했습니다
- 어느 페이지에서 옮겼나 — 같은 오퍼스 5가 OpenAI 페이지에서 52.6%, 앤트로픽 페이지에서 52.3%입니다. 그리고 열을 한 칸 밀려 읽으면 7.8%p 차이가 됩니다. 제가 그랬습니다
- 몇 번 시도한 값인가 — 앤트로픽이 밝힌 어긋남의 이유 하나가 이것이었습니다. 문항당 한 번인지 세 번인지
- 같은 문제집인가 — 같은 GPT-5.6 솔이 같은 「최대」 칸에서 시험용 7.8% · 연습용 13.3%입니다. 문제집만 바꿔도 1.7배입니다. 여기에 설정까지 켜면 같은 연습용에서 38.3%가 되는데, 이 값이 실린 문장에는 칸이 안 붙어 있습니다
정리하면
「AGI 시대」라는 말은 나왔습니다. 회사 사람이 단서를 달아 했습니다. 시험을 만든 쪽은 「큰 도약이지만 아직 AGI라 부를 근거는 없다」로 갈라 말했습니다.
같이 돌아다닌 99.9%는 맞힌 개수가 아니라 사람 대비 손놀림 효율입니다. 다른 AI를 재던 방법으로 조건까지 맞추면 54.8%이고, 그 방법에서 아스트라가 낸 가장 높은 점수가 62.7%입니다. 그리고 그 62.7%도 초라한 값이 아닙니다.
그리고 이건 아스트라만의 이야기가 아닙니다. 같은 클로드 오퍼스 5를 두고도 30.2%와 100.00이라는 두 숫자가 돌아다닙니다. 조건이 다섯 가지나 달라서 견주면 안 되는 값들이고, 그래서 저도 견주지 않았습니다. 다만 조건을 안 적으면 이런 일이 생긴다는 건 어느 회사 쪽이든 같습니다.
숫자를 깎으려고 쓴 글이 아닙니다. 숫자가 뭘 재는지 모른 채 옮기면 깎는 쪽으로도 띄우는 쪽으로도 똑같이 틀린다는 이야기입니다. 저는 이 글 하나에서 양쪽으로 다 틀렸습니다.
더 자세히 보고 싶은 분께
여기부터는 원래 표기와 영어 원문입니다. 위 내용만 보셔도 충분합니다.
점수 계산식 — 이 점수의 이름은 RHAE (Relative Human Action Efficiency)입니다 (ARC Prize 공식 채점 문서)
level_score = (human_baseline_actions / ai_actions) ^ 2
한 판당 상한은 사람 기준의 1.15배이고, 게임 점수는 판별 점수의 가중평균인데 가중치가 판 번호입니다. 그래서 다섯 판 중 네 판이면 (1+2+3+4)÷(1+2+3+4+5)로 66.7%가 됩니다. ⚠️ 이건 각 판을 1.00으로 쳤을 때의 값이고, ARC Prize 문서가 든 예시 그대로입니다.
두 방법의 정식 이름 — 보통 방법은 Standard Harness, 아스트라 쪽에 붙어 있는 것은 Provider Adapter입니다. ARC Prize 설명 원문입니다.
The Provider Adapter harness preserves opaque reasoning state between requests and uses compaction for longer conversations, allowing the model to reuse prior work.
7월에 공개된 두 설정의 이름은 retained reasoning과 compaction입니다.
생각하는 시간 손잡이 — None · Low · Medium · High · XHigh · Max 여섯 칸입니다. 보통 방법으로 잰 아스트라 점수 전부입니다.
| 아스트라 · 보통 방법 | 점수 |
|---|---|
| Max | 62.7% |
| XHigh | 59.3% |
| High | 54.8% |
| Medium | 38.6% |
| None | 35.2% |
| Low | 17.5% |
Low부터 Max까지는 칸 순서대로 점수도 올라갑니다. 그런데 맨 아래 칸인 None만 그 흐름을 벗어납니다. None(35.2%)이 바로 위 칸인 Low(17.5%)보다 두 배 높고, 그 위의 Medium(38.6%)에 가깝습니다. 생각을 아예 안 시킨 쪽이 조금 시킨 쪽보다 잘한 겁니다. 왜 그런지는 표에 설명이 없습니다.
따로 써준 방법 쪽은 여섯 칸이 96.7%에서 99.95% 사이에 다 몰려 있습니다. Max 98.6% · High 99.95%로, 이쪽에서는 「최대」가 가장 높지 않습니다. ⚠️ 99.9%가 어디서 나온 숫자인지도 짚어두겠습니다. ARC Prize 결과 페이지 머리글도 99.9%로 적고 있고(상세 표의 99.95%를 버린 표기입니다), OpenAI 발표 페이지도 직접 99.9%라고 적었습니다.
본문에는 「아스트라가 ARC-AGI-3를 99.9%로, ExploitBench를 100%로 포화시켰다」고 적혀 있습니다. 여기엔 장치도 칸도 안 붙어 있습니다.
🔑 그런데 페이지 맨 아래 각주에 장치가 적혀 있습니다. 「ARC-AGI-3에서 아스트라는 우리 responses API 장치로 돌렸다. 실제 쓰임새에 더 맞추려고 설정 두 개를 바꾼 장치다. 그 변경이 ARC-AGI-3를 콕 집어 겨냥한 것은 아니다」라고요.
👉 「설정 두 개」 — 앞에서 본 그 두 설정입니다. 즉 OpenAI도 장치를 밝히긴 했습니다. 본문이 아니라 맨 아래 각주에서요. 숫자만 옮기는 사람은 각주까지 안 내려갑니다. 저도 처음엔 못 봤습니다.
⚠️ 각주에도 어느 손잡이 칸인지는 없습니다. 「높음」이라는 건 ARC Prize 쪽에서만 확인됩니다.
그리고 같은 페이지에 이런 인용도 실려 있습니다. 「아스트라가 판의 96%에서 우리 쪽 사람 행동 효율 기준선을 넘어섰고, 사실상 이 시험에서 사람과 대등해졌다」 — 말한 사람은 OpenAI가 아니라 시험을 만든 ARC Prize 재단 쪽(그렉 캄라트)입니다. 이름이 비슷하지만 앞에 나온 브록만과는 다른 사람이고, 소속도 반대편입니다. 그러니 여기서 「우리 쪽 기준선」은 채점식이 쓰는 그 기준선입니다.
⚠️ 이 96%는 99.9%와 같은 실행에서 나온 값이 아닙니다. ARC Prize 쪽 글을 보면 따로 써준 방법의 「최대」 칸에서 잰 것이라, 점수로는 98.6%짜리 실행입니다. 99.9%는 「높음」 칸이고요.
⚠️ 게다가 96%는 「판의 개수 비율」이고 99.9%는 「손놀림 효율 점수」입니다. 칸도 척도도 다르니 나란히 놓고 읽으시면 안 됩니다.
비용 — 시험 한 세트를 다 도는 총액입니다.
| 아스트라 · 세트 총액 | 값 |
|---|---|
| 보통 방법 · Max | $26,098 |
| 따로 써준 방법 · Max | $17,332 |
| 따로 써준 방법 · High | $18,817 |
점수가 높다고 더 비싸지는 게 아닙니다. ARC Prize는 「생각을 더 들이는 칸일수록 대체로 더 적은 손놀림으로 풀어서 총 비용이 내려간다」고 적었습니다.
⚠️ 다만 「대체로」입니다. 보통 방법의 여섯 칸 총액을 그대로 옮기면 이렇습니다.
| 보통 방법 · 손잡이 칸 | 세트 총액 |
|---|---|
| None | $49,791 |
| Low | $38,166 |
| Medium | $48,090 |
| High | $40,705 |
| XHigh | $37,317 |
| Max | $26,098 |
Max가 가장 싼 건 맞습니다. 그런데 Max를 빼면 순서대로 내려가지 않습니다. Low가 Medium·High보다 싸니까요.
⚠️ 그리고 점수와 비용이 나란히 가지도 않습니다. 위 표에서 Medium은 38.6%인데 $48,090이고, High는 54.8%인데 $40,705입니다. 점수가 더 높은 쪽이 더 쌉니다. 따로 써준 방법에서도 가장 높은 점수(High 99.95%)가 가장 싼 칸은 아닙니다. High가 $18,817, Max가 $17,332니까요.
⚠️ ARC Prize는 사람에게 게임을 시킬 때 드는 값도 같이 적어뒀습니다. 사람을 모아 실제로 게임을 시켜야 기준선이 나오니까요. 게임 하나를 붙잡는 데 약 $12.78(성과급 제외)입니다. 게임 하나 안에 여러 판이 들어 있고, 위 표는 시험 한 세트 총액입니다. 세는 단위가 다르니 나눠서 비교하면 안 됩니다.
ARC-AGI-1·2 값 — 칸을 밝혀 적습니다.
| ARC-AGI-1 | 점수 |
|---|---|
| 아스트라 Max | 97.5% |
| 페이블 5.1 Max | 97.5% |
| 아스트라 XHigh · High | 98.5% |
| 페이블 5.1 XHigh | 96.5% |
| 페이블 5.1 High | 96.0% |
| 오퍼스 5 High · Max | 97.5% |
| ARC-AGI-2 | 점수 |
|---|---|
| 아스트라 Max | 95.0% |
| 오퍼스 5 Max | 90.4% |
| 페이블 5.1 Max | 90.0% |
⚠️ 이 두 시험은 아스트라 쪽에 어떤 장치로 쟀는지도, 어느 문제집으로 쟀는지도 안 적혀 있습니다. 클로드 쪽은 「시험용」으로 밝혀져 있지만(페이블 5.1은 ARC-AGI-1·2 둘 다, 오퍼스 5는 ARC-AGI-2), 아스트라 쪽에 표기가 없어 같은 문제집인지 확인하지 못했습니다.
엔비디아 AVO 결과 — 오퍼스 5로 연습용 25개 환경 183판을 전부 완주, 6,624번의 행동, RHAE 점수 100.00. 관측을 64×64 글자 격자로 넘겼습니다.
아스트라 사양 (OpenAI 개발자 문서) — 컨텍스트 105만, 최대 출력 12만 8천, 지식 컷오프 2026년 4월 30일. 클로드 쪽은 오퍼스 5와 페이블 5.1 모두 100만 · 12만 8천입니다.
⚠️ 마이크 누프의 글은 그의 계정을 직접 열지 못해 검색에 잡힌 본문으로 옮겼습니다. 뒤에 문장이 더 있을 수 있습니다.
같이 보면 좋은 글
- 클로드 페이블 5.1과 미토스 5.1의 차이 — 이 글에 나온 페이블 5.1이 어떤 모델인지
- 클로드 AI 사용법 2026 — 처음 쓰는 분들용
- 클로드 무료 유료 차이 7가지 — 결제 전에 보는 글
- 챗GPT 무료와 클로드 무료 5가지 비교 — 두 서비스 무료 범위
- 클로드 글쓰기 프롬프트 여섯 가지 — 공식 문서에서 고른 것
- 클로드 프로젝트 지침 쓰는 법 — 길게 쓰는 분들용
- 클로드 아티팩트 사용법 — 결과물을 화면으로 받는 기능
- 애드센스 「가치가 별로 없는 콘텐츠」 — AI 때문일까 — 정책 본문엔 AI가 없었고, 막는 건 「자동 생성」이었습니다
근거로 쓴 곳
2026년 9월 7일에 직접 열어 적었습니다.
- ARC Prize 리더보드 — 모델별 점수와 비용
- ARC Prize · 아스트라 분석 — 두 방법 표, 사람 기준선, AGI에 대한 입장
- ARC Prize · 공식 채점 문서 — 점수 계산식
- ARC Prize · GPT-6 아스트라 결과 — 두 장치의 여섯 칸 점수
- ARC Prize · 클로드 오퍼스 5 결과 — 30.2%와 최대 칸이 빈 이유
- ARC Prize · 클로드 페이블 5.1 결과 — 다섯 칸이 빈 표
- ARC Prize · GPT-5.6 솔 결과 — 시험용 7.8% · 연습용 13.3%
- OpenAI · GPT-6 Astra 발표 — 가격, 쓸 수 있는 곳, 안전 관련 서술
- OpenAI · 설정 두 개로 점수가 세 배가 된 이야기 — 두 설정과 사람 평균 48%(연습용 · 추정)
- OpenAI · GPT-6 Astra 개발자 문서 — 컨텍스트, 캐시 값, 27만 2천 초과 구간
- 앤트로픽 · 클로드 페이블 5.1과 미토스 5.1 — 클로드 쪽 값과 벤치마크
- 앤트로픽 · 페이블 5.1 플랫폼 문서 — 어느 모델을 언제 쓰라는 권고
- 엔비디아 · AVO가 100을 낸 이야기 — 오퍼스 5를 감싼 결과
- Axios · 브록만 브리핑 보도 — 매체 보도
- ARC Prize 정책 문서 — 연습용·시험용 문제집 구분
- The Next Web · 발표 뒤 수치 수정 보도 — 매체 보도
- 마이크 누프 게시물 — ARC Prize 공동창업자 본인 계정. ⚠️ 이 계정만 직접 열지 못해 검색에 잡힌 본문으로 옮겼습니다
영어를 한국어로 옮긴 건 전부 제가 한 것이고, 원문은 위 「더 자세히 보고 싶은 분께」에 그대로 실었습니다.